Pangram y el peligro de confiar en exceso en la IA para detectar IA en la industria editorial
Investigadores y analistas advierten que la adopción apresurada e irrestricta de este detector expone a autores a acusaciones infundadas por falsos positivos.
Cuando se anunció, Pangram parecía la respuesta a un millón de oraciones: Una herramienta de detección de inteligencia artificial capaz de advertir, con alto grado de certeza, que un texto fue escrito con inteligencia artificial. Pero, verán, justamente en lo de "certeza" es que está el problema.
Es así que hoy, a pesar de ser ampliamente usada en los entornos académicos, profesionales, periodísticos y literarios-, la herramienta viene rodeada de severas advertencias emitidas por expertos tecnológicos y analistas sobre su falta de fiabilidad en el mundo real.
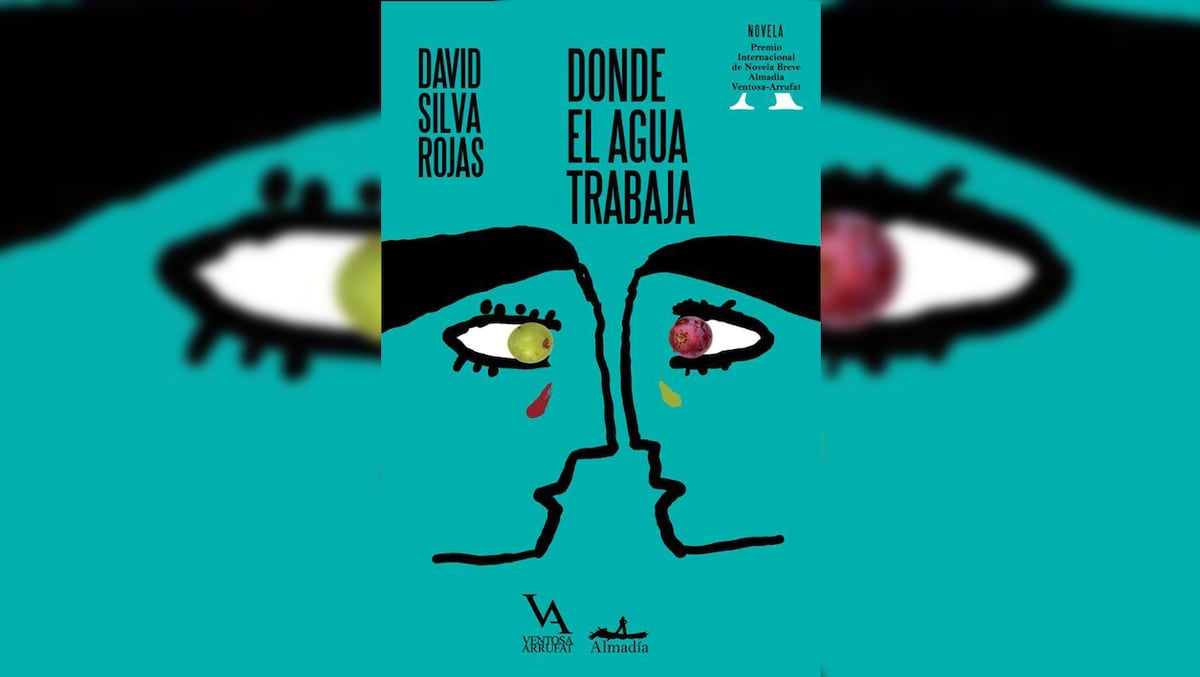
El debate se intensificó tras revelarse escaneos masivos realizados por medios de comunicación como el periódico El País, que utilizó el software para examinar una selección de obras literarias. En dicho ejercicio, Pangram atribuyó un 99% de probabilidades de haber sido generada por IA a la novela Donde el agua trabaja, del autor peruano David Silva Rojas, recientemente galardonada con el Premio Internacional de Novela Breve Ventosa-Arrufat / Almadía.
Por qué importa
El uso no contrastado de software de detección algorítmica genera preocupación entre creadores, agentes literarios y casas editoriales de América Latina y España. El principal riesgo radica en la vulnerabilidad a la que quedan expuestos los autores frente a falsos positivos producidos por herramientas sin auditoría independiente.
En el caso de la obra cuestionada, El País explicó: "Hace una semana, este periódico analizó 175 libros populares en España. Uno de cada tres superventas autopublicados contiene mucho texto generado con IA, según el detector Pangram. Ninguno de los libros premiados analizados daba señales. Ahora ha surgido el primer sospechoso: Donde el agua trabaja. Pangram dice que el 99% del texto de la novela está generado con un modelo de IA. Hemos analizado el libro entero, unas 26.000 palabras, con la versión 4.1 de Pangram".
A pesar de que el escritor negó categóricamente el uso de modelos sintéticos y la editorial Almadía manifestó su confianza en el autor, las presentaciones de la obra fueron suspendidas mientras se realiza una investigación interna.
La ausencia de un canal claro de apelación o de retroalimentación en la plataforma impide que las editoriales certifiquen si un resultado es un error estilístico del algoritmo o un caso real de generación sintética. La acusación, sin embargo, queda en el aire, sin manera de examinarla, corregirla o refutarla.
La controversia se profundiza por los crecientes conflictos de interés denunciados dentro del ecosistema tecnológico-literario. Diversos análisis advierten sobre el impacto de patrocinios e inversiones por parte de empresas desarrolladoras dentro de conferencias, asociaciones académicas y agencias literarias de renombre. Al establecer relaciones comerciales y personales directas con los actores de la industria, estas plataformas promueven un clima de adopción ciega que sustituye la lectura crítica humana por veredictos automatizados y, como decíamos, inapelables.
Qué sigue
Ante el aumento de casos donde obras publicadas sufren suspensiones preventivas, colectivos de escritores e investigadores independientes demandan frenar la implementación de Pangram como criterio de exclusión o sanción contractual. Entre las medidas inmediatas propuestas destaca la creación de un registro público de falsos positivos (bajo la etiqueta #PangramFail) para documentar errores sistemáticos cometidos sobre obras redactadas y publicadas previamente al auge de la IA generativa comercial.
Organizaciones del sector exigen que las agencias y grupos editoriales integren a los propios autores en las mesas de evaluación donde se decide la adopción de estas tecnologías. Para las próximas semanas se prevé el diseño de pruebas de estrés independientes dirigidas por laboratorios académicos neutrales. El objetivo es evaluar el comportamiento real de Pangram sobre flujos de trabajo editoriales diversos, alejándose de los datos de laboratorio controlados ofrecidos por la propia compañía desarrolladora.
Contexto
El desarrollo de herramientas para identificar texto generado por grandes modelos de lenguaje (LLM) creció de manera acelerada tras el lanzamiento de ChatGPT por OpenAI a finales de 2022. No obstante, consensos científicos de entidades como la Universidad de Stanford y el MIT han reiterado de forma continua que los detectores basados en métricas de perplejidad y ráfaga (burstiness) son inherentemente inestables y presentan un sesgo sistemático contra escritores no nativos del idioma inglés o autores con estilos métricos repetitivos.
Empresas del sector han publicitado tasas de error tan bajas como 1 en 24.000 en entornos de prueba controlados. Sin embargo, analistas de datos subrayan que dichos porcentajes provienen de conjuntos de entrenamiento (test sets) cerrados con proporciones fijas de contenido (50% humano y 50% sintético), condiciones que no representan la complejidad de un manuscrito literario. En la práctica, los expertos estiman que la precisión real de estos sistemas difícilmente supera el 75% o 80%, un margen de duda demasiado alto para justificar su uso como "policía literaria" en la industria editorial.